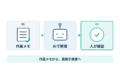
スキャンPDFは、ページ全体が画像として保存されていることがあり、そのままでは表データとして扱えません。その場合は、OCR(文字認識)を行ってからExcelへ移します。
ただし、OCRできたことと、正しく読み取れたことは別です。見た目が整っていても、数字や管理番号が1文字だけ違ったり、行と列がずれたりすることがあります。この記事では、Adobe Acrobat ProでスキャンPDFをOCRしてExcel形式へ書き出し、元PDFとの照合を終えるまでの手順を説明します。
通常PDFとスキャンPDFの違い
パソコン上で作成された通常PDFは、文字情報を持っていることがあり、文字をドラッグして選択できる場合があります。一方、紙をスキャンしたPDFは、ページ全体が画像として保存され、文字を選択できない場合があります。
ただし、文字を選択できるかどうかだけでPDFの種類を100%判定できるわけではありません。画像として保存された表をExcelへ移すには、OCR工程が必要になることがあります。
- 通常PDF:文字情報を持つ場合があり、ExcelのPDF取込などを先に試せる
- スキャンPDF:画像として保存されている場合があり、OCRで文字や表を認識する工程が必要
完成例|スキャンPDFをExcelへ移す流れ
今回の完成条件は、Excelファイルができることではなく、元PDFと照合して誤認識を修正できることです。
スキャンPDF → OCR → 文字・表を認識 → Excelへ書き出す → 元PDFと照合 → 修正 → 完成
- 元のスキャンPDFを残したまま、作業用コピーを用意する
- Acrobat Proで日本語を指定してOCRする
- OCR後のPDFをExcel(XLSX)形式へ書き出す
- 行数・列数・見出しを確認する
- 管理番号・数量・単価・金額・日付を元PDFと照合する
- 誤認識や列ずれを修正する
- 合計と抜き取り確認を行い、業務で使える状態にする
今回使う架空の購入一覧
照合方法を具体的にするため、実在する会社や取引とは関係のない「月次備品購入一覧」を使います。管理番号、品名、数字、日付、空欄を含む小さな表です。
| 管理番号 | 品名 | 数量 | 単価 | 金額 | 購入日 | 備考 |
|---|---|---|---|---|---|---|
| A-001 | USBケーブル | 12 | 980 | 11,760 | 2026/09/02 | 追加 |
| A-008 | HDMIケーブル | 5 | 1,580 | 7,900 | 2026/09/05 | |
| B-015 | 電源タップ | 8 | 2,450 | 19,600 | 2026/09/11 | 定期 |
| C-021 | 変換アダプタ | 3 | 3,280 | 9,840 | 2026/09/18 | 予備 |
この表には、0(ゼロ)と英字、1とI、5とS、8とBを見分ける材料があります。管理番号にはハイフンと先頭ゼロ、金額にはカンマ、品名には日本語と英字が含まれます。2行目の備考は空欄です。
なお、この記事の制作環境ではAcrobat Proを利用できなかったため、この表に対するOCRの実機結果は取得していません。以下で挙げる文字の組み合わせは、今回発生した誤りではなく、OCR後に確認するポイントです。
スキャンPDFへOCRをかける
主手順には、デスクトップ版Adobe Acrobat Proを使います。Adobe公式のプラン比較では、スキャン文書を編集・検索可能なPDFへ変換するOCRはAcrobat Proの機能として案内されています。無料のAcrobat Readerだけで同じデスクトップ手順を使えるとは限りません。契約中のプランと画面を確認してください。
- 元PDFを残し、作業用コピーをAcrobat Proで開きます。
- すべてのツールからスキャンとOCRを選びます。
- このファイル内を選びます。
- 対象ページを指定し、文書の言語を日本語にします。
- テキスト認識を実行します。
- 処理後、文字を選択・検索できるかを確認します。
Adobe公式も、OCR実行後にテキストが正確で完全かを確認し、必要に応じて手動修正または設定を調整した再実行を行うよう案内しています。OCR直後を完成状態にしないでください。
OCR結果をExcelへ移す
- OCR後のPDFを開いたまま、Acrobatの変換を選びます。
- 左側でMicrosoft Excelを選び、形式をXLSXにします。
- 必要なら設定を開き、表またはページごとのワークシート、桁区切り記号、テキスト認識言語を確認します。
- XLSXに変換を選び、作業用フォルダーへ保存します。
- Excelで開き、元PDFを横に並べて確認します。
メニュー名や配置はAcrobatの更新状況で変わる場合があります。書き出し後にExcelで表が開けても、値の一致はまだ確認できていません。
最初に確認する行数・列数・見出し
最初に表全体の形を確認します。今回の架空表なら、見出しを除くデータは4行、列は7列です。
- データ行が4行あるか
- 管理番号から備考まで7列あるか
- 見出しが欠けたり、別の列へ入ったりしていないか
- 各行の品名・数量・単価・金額・購入日が横に対応しているか
- 1セルが2列へ分かれたり、2セルが1セルへ結合されたりしていないか
- 元PDFで空欄の備考が、空欄のままか
列数が合っていても、一部の行だけずれる場合があります。先頭のA-001、中間のA-008またはB-015、末尾のC-021を抜き取り、行を横方向に照合します。
数字・管理番号・日付を確認する
数字は見た目ではなく値を照合する
業務用の表では、1文字の数字違いが数量や金額に影響します。たとえば元PDFの「11,760」がExcelでも「11,760」なら一致です。「11,160」なら、見た目が似ていても値は誤りです。
少なくとも数量・単価・金額を確認します。4行程度なら全件、行数が多い場合でも先頭・中間・末尾から抜き取り、元PDFの同じセルと比べます。
管理番号は文字列として確認する
管理番号A-001、A-008、B-015、C-021では、次を確認します。
- ハイフンが消えていないか
- 0(ゼロ)がO(英字オー)になっていないか
- 1(数字イチ)がI(英字アイ)になっていないか
- 先頭ゼロが落ちていないか
管理番号は計算用の数値ではありません。Excelで先頭ゼロを保つ必要がある場合は、列を文字列として扱い、元PDFと一致する形へ修正します。
日付は表示形式と値を分ける
元PDFの「2026/09/02」がExcelで「2026/9/2」と表示されるだけなら、同じ日付を別の表示形式で示している可能性があります。一方、「2026/09/12」になっていれば値そのものが違います。
年・月・日が一致するかを確認したうえで、並べ替えや計算に使う場合は、Excel内部で日付値として認識されているかも確認してください。
元PDFと値が一致していても日付が文字列のままなら、並べ替えや期限判定の前に文字列の日付をExcelの日付値へ直す手順を確認してください。
0/O・1/I・ハイフンなどの誤認識を確認する
OCRでは、文字の形や画像品質によって似た文字が別の文字として認識される可能性があります。次は必ず起きる誤りではなく、確認候補です。
| 確認候補 | 今回の表で見る場所 |
|---|---|
| 0 と O | A-001、A-008などの管理番号 |
| 1 と I | B-015、HDMIケーブル |
| 5 と S | B-015、USBケーブル |
| 8 と B | A-008、B-015、USBケーブル |
| ハイフンの欠落 | A-001など4件の管理番号 |
| カンマの欠落 | 11,760、7,900、19,600、9,840 |
| 日本語1文字の違い | 電源タップ、変換アダプタなどの品名 |
今回の制作ではOCR実機結果を取得していないため、「この誤認識が発生した」とする検証結果はありません。実際のファイルでは、誤りが見つかったセルだけを元PDFに合わせて修正し、修正後に同じ列を再確認します。
合計値で大きな誤りを確認する
架空表の金額合計は49,100円です。
11,760 + 7,900 + 19,600 + 9,840 = 49,100Excelへ移した金額がE2:E5にある場合は、空いているセルで次の式を使えます。
=SUM(E2:E5)元PDF側の正しい合計49,100とExcel側の合計を比べると、行の欠落や大きな数字違いに気づきやすくなります。ただし、合計が一致しても全セルが正しいとは判断できません。複数の誤りが相殺されることや、文字列になった金額が集計対象から外れることがあるためです。合計確認とセル単位の抜き取り確認を組み合わせます。
OCRがうまくいかないときに確認すること
OCR結果は、元画像の状態や表の作りによって変わります。次を確認してください。
- 文字が小さすぎないか
- ページが傾いていないか
- 解像度が低く、文字の輪郭が崩れていないか
- 汚れや影が文字に重なっていないか
- 文字が薄くなっていないか
- 複雑な罫線や結合セルが認識を妨げていないか
- OCR言語が日本語になっているか
画質を改善して再実行しても、誤認識がなくなるとは限りません。原本の状態が悪い場合は、重要な値を手入力し、別の人や別工程で照合する方法も検討します。
オンラインサービスを使う場合は、顧客名、個人情報、契約情報、金額情報、未公開情報、社外秘情報が含まれていないかを確認し、会社のルール、利用条件、データの保存・利用・削除方法を確認してください。デスクトップソフトやローカル処理でも、設定や同期先を含めて必ず安全とは断定できません。
コピーして使えるOCR後チェックリスト
【表】
□ 行数・列数・見出しを確認した
□ 行と列の対応、空欄を確認した

【数字】
□ 数量・単価・金額を確認した
□ 日付と合計を確認した

【OCR特有】
□ 0/O、1/I、5/S、8/Bを確認した
□ ハイフン、カンマ、先頭ゼロを確認した
□ 管理番号と日本語を元PDFと照合した

【完了】
□ 誤りを修正し、元PDFと再照合した
通常PDFなら別の方法を使える
文字を選択できる通常PDFで、表が文字情報を持っている場合は、OCRをかける前にPDFの表をExcelに変換する方法を試せます。Post469は通常PDFをExcelへ取り込み、変換後の行列・数字を確認する記事です。
今回の記事は、画像PDF・スキャンPDFを先にOCRし、0/O、1/I、ハイフン、先頭ゼロなどOCR特有の誤認識を確認する役割です。通常PDFとスキャンPDFを同じ手順として扱わないでください。
照合後のデータを管理表へ移し、入力値を統一する場合はExcelでステータスをプルダウンにする方法、期限切れの未完了行を見つけやすくする場合はExcelで期限切れの未完了行だけ色を付ける方法を使い分けてください。
まとめ
スキャンPDFをExcelへ移すときは、Acrobat ProでOCRを実行し、Excel形式へ書き出した後に、元PDFとの照合を行います。確認するのは、行数・列数・見出しだけではありません。管理番号、数量、単価、金額、日付、空欄、0/Oなどの似た文字も確認します。
合計値は大きな誤りを見つける助けになりますが、全セルの正しさを保証しません。先頭・中間・末尾を抜き取り、重要な数字と識別番号をセル単位で照合してから業務に使ってください。
参考:Adobe「スキャンした文書内のテキストの認識」、Adobe「PDFをMicrosoft Excel形式に変換」、Adobe「Acrobatプランを比較」